تصور کنید یک مدل هوش مصنوعی برای تولید محتوا آموزش دیده است. این مدل با بررسی میلیونها صفحه وب، الگوهای زبانی، اطلاعات تخصصی و شیوه پاسخگویی به پرسشهای کاربران را یاد میگیرد. حالا تصور کنید نسل بعدی همین مدل، بهجای یادگیری از اطلاعات متنوع و منابع دستاول، بخش بزرگی از آموزش خود را از محتوایی دریافت کند که مدلهای قبلی تولید کردهاند.
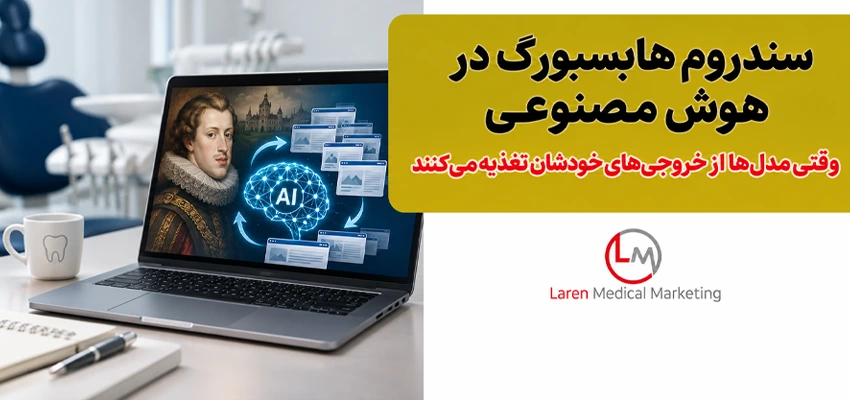
سندروم هابسبورگ در هوش مصنوعی؛ وقتی مدلها از خروجیهای خودشان تغذیه میکنند
در چنین شرایطی، چه اتفاقی میافتد؟ آیا مدل همچنان میتواند اطلاعات دقیقتر و متنوعتری تولید کند یا بهتدریج در چرخهای از تکرار، سادهسازی و بازتولید خطاها گرفتار میشود؟
برای درک بهتر این مسئله، میتوان از یک نمونه تاریخی الهام گرفت: خاندان هابسبورگ؛ خانوادهای سلطنتی که داستان ازدواجهای درونخاندانی آنها، امروز به استعارهای برای توضیح یکی از چالشهای مهم هوش مصنوعی تبدیل شده است.
خاندان هابسبورگ چه ارتباطی با هوش مصنوعی دارد؟
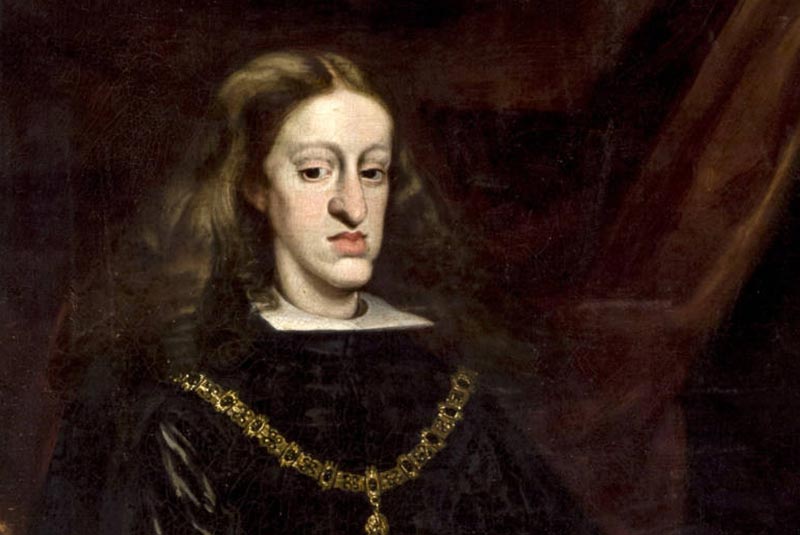
خاندان هابسبورگ قرنها از خاندانهای تأثیرگذار اروپا بود. اعضای این خانواده برای حفظ قلمرو، ثروت و قدرت سیاسی، در نسلهای مختلف با خویشاوندان نزدیک خود ازدواج میکردند. تکرار این ازدواجها باعث افزایش همخونی و کاهش تنوع ژنتیکی در برخی شاخههای خاندان شد و احتمال بروز بعضی مشکلات ارثی را افزایش داد.
کارلوس دوم، آخرین پادشاه هابسبورگی اسپانیا، یکی از مشهورترین نمونههای این تاریخ است. او با مشکلات جسمی متعددی روبهرو بود و در سال ۱۷۰۰ میلادی، بدون وارث درگذشت. با مرگ او، شاخه اسپانیایی خاندان هابسبورگ پایان یافت.
البته سرنوشت این خاندان را نمیتوان صرفاً به یک عامل ژنتیکی نسبت داد؛ بااینحال، تاریخ آنها نمونهای روشن از پیامدهای احتمالی تکرار در یک چرخه محدود است.
از ژنتیک تا داده
حالا همین منطق را از دنیای ژنتیک به دنیای داده منتقل کنیم. در یک سیستم هوش مصنوعی، مسئله دیگر تکرار ژنها نیست؛ بلکه تکرار دادهها و الگوهای اطلاعاتی است. اگر مدلهای جدید بهطور فزاینده از خروجی مدلهای قبلی آموزش ببینند و دسترسی کافی به دادههای متنوع و واقعی نداشته باشند، ممکن است بخشی از اطلاعات ارزشمند و کمتکرار را از دست بدهند و خطاهای موجود در دادههای قبلی را نیز بازتولید کنند.
این پدیده در پژوهشهای هوش مصنوعی با اصطلاح Model Collapse یا فروپاشی مدل شناخته میشود.
فروپاشی مدل (Model Collapse) چیست؟
فروپاشی مدل به وضعیتی اشاره دارد که در آن آموزش مکرر مدلهای مولد با دادههای تولیدشده توسط مدلهای قبلی، بهتدریج کیفیت توزیع اطلاعاتی یادگرفتهشده را کاهش میدهد.
برای مثال، فرض کنید یک مدل زبانی از مجموعهای متنوع از متون انسانی، اسناد تخصصی، گزارشها و مقالات آموزش دیده است. این دادهها شامل اطلاعات رایج و غیررایج، دیدگاههای متفاوت و جزئیات متنوعی هستند.
مدل از این مجموعه، الگوهایی برای تولید متن یاد میگیرد. اگر مدل دیگری عمدتاً با خروجیهای همین مدل آموزش ببیند و این فرایند در نسلهای بعد ادامه پیدا کند، ممکن است اطلاعات کمتکرار و جزئیات مهم بهتدریج کمتر بازنمایی شوند. در نتیجه، خروجیها میتوانند یکنواختتر شوند و برخی خطاها نیز در چرخه تولید و آموزش باقی بمانند.
چرخه فروپاشی مدل در ۴ مرحله
وقتی خروجی مدلها بدون کنترل به ورودی نسل بعد تبدیل میشود
مرحله ۰۱
مرحله ۰۲
مرحله ۰۳
مرحله ۰۴
↻ و این چرخه در هر نسل تکرار میشود…
البته این اتفاق در هر شرایطی رخ نمیدهد. استفاده از دادههای مصنوعی بهخودیخود به معنای فروپاشی مدل نیست؛ کیفیت دادهها، میزان تنوع آنها، نحوه انتخاب نمونهها و ترکیب آنها با دادههای واقعی اهمیت زیادی دارد.
مسئله اصلی: وابستگی فزاینده به دادههای تولیدشده توسط مدلها، بدون کنترل کافی کیفیت و تنوع آنهاست.
آیا اینترنت هم میتواند به چرخهای از محتوای تکراری تبدیل شود؟
یکی از موضوعات مهم در این بحث، افزایش محتوای تولیدشده با هوش مصنوعی در اینترنت است.
امروزه کسبوکارها از ابزارهایی مانند ChatGPT و Claude برای تولید مقاله، توضیحات محصول، صفحات فرود و محتوای شبکههای اجتماعی استفاده میکنند. این ابزارها میتوانند سرعت تولید را افزایش دهند؛ اما نتیجه به نحوه استفاده از آنها بستگی دارد.
فرض کنید صدها وبسایت درباره یک موضوع مشخص مقاله منتشر میکنند. هر وبسایت محتوای رقبای خود را به یک مدل هوش مصنوعی میدهد و از آن میخواهد مقالهای جامعتر، روانتر و سئوشدهتر تولید کند.
اگر ورودیها خودشان تکراری و فاقد اطلاعات دستاول باشند، خروجیهای جدید نیز ممکن است همان اطلاعات را با ساختار و واژگان متفاوت بازتولید کنند.
در این وضعیت، تعداد صفحات منتشرشده افزایش پیدا میکند، اما لزوماً دانش تازهای به اینترنت اضافه نمیشود.
یک تفاوت مهم
این مسئله را نباید با فروپاشی مدل یکسان دانست. فروپاشی مدل یک پدیده مشخص در فرایند یادگیری مدلهای هوش مصنوعی است؛ اما تولید انبوه محتوای مشابه در وب، نمونهای از همان نگرانی گستردهتر درباره کاهش تنوع اطلاعات و بازتولید مکرر محتواست.
این تفاوت مهم است؛ زیرا برای حل هر مسئله باید ابتدا ماهیت واقعی آن را بشناسیم.
یک مثال کاربردی از سئو دندانپزشکی
فرض کنید مسئول سئو یک وبسایت دندانپزشکی هستیم و میخواهیم مقالهای با موضوع «ایمپلنت بدون جراحی لثه» منتشر کنیم.
برای شروع، پنج صفحه برتر نتایج گوگل را بررسی میکنیم و محتوای آنها را در اختیار Claude قرار میدهیم. سپس از مدل میخواهیم مقالهای کاملتر از رقبا تولید کند؛ مقالهای که ساختار مناسبی داشته باشد، به پرسشهای کاربران پاسخ دهد و از نظر سئو نیز بهینه باشد.
مدل میتواند در چند دقیقه مقالهای منسجم با تیترهای مناسب، مقدمه جذاب و توضیحات نسبتاً کامل تولید کند.
اما یک سؤال اساسی وجود دارد: آیا مقاله جدید واقعاً بهتر از صفحات قبلی است؟
فرض کنیم هر پنج رقیب، اطلاعات مشابهی درباره مزایا، مراحل انجام و هزینه ایمپلنت بدون جراحی ارائه کردهاند. در این صورت، مدل احتمالاً همین اطلاعات را ترکیب و بازنویسی میکند.
ممکن است مقاله نهایی از نظر نگارش بهتر باشد؛ اما همچنان به پرسشهای مهمی پاسخ ندهد، از جمله:
- آیا ایمپلنت بدون برش لثه برای همه بیماران مناسب است؟
- چه عواملی بر امکان استفاده از این روش تأثیر میگذارند؟
- در چه شرایطی ممکن است به روش جراحی متداول نیاز باشد؟
- چه تفاوتی میان ایمپلنت با روش کمتهاجمی و ادعاهای تبلیغاتی درباره ایمپلنت بدون جراحی وجود دارد؟
- بیمار برای انتخاب روش مناسب باید چه اطلاعاتی را از دندانپزشک دریافت کند؟
برای پاسخ دقیق به این پرسشها، صرفاً بازنویسی رقبا کافی نیست. باید به منابع معتبر پزشکی مراجعه کنیم، محدودیتهای روش را بشناسیم و در صورت امکان از دانش و تجربه متخصص مربوطه استفاده کنیم.
نکته مهم: این پرسشها باید با شواهد پزشکی معتبر پاسخ داده شوند؛ نه اینکه صرفاً برای کاملتر شدن مقاله، پاسخهایی ظاهراً قانعکننده به آنها اضافه کنیم.
حالا سناریو را یک مرحله جلوتر ببریم.
وبسایت دیگری مقاله ما را بررسی میکند و با کمک هوش مصنوعی، نسخهای متفاوت از آن مینویسد. سایت سوم نیز همین کار را تکرار میکند. پس از مدتی، دهها مقاله درباره یک موضوع در اینترنت منتشر شدهاند که بخش زیادی از اطلاعات آنها از یکدیگر گرفته شده است.
در ظاهر، محتوای بیشتری تولید شده؛ اما آیا اطلاعات تازهای به دست کاربران رسیده است؟
اگر پاسخ منفی باشد، با مسئلهای روبهرو هستیم که برای استراتژی محتوا اهمیت زیادی دارد: افزایش حجم محتوا، بدون افزایش متناسب ارزش اطلاعاتی آن.
این مسئله چه اهمیتی برای سئو دارد؟
در سئو، بررسی رقبا، تحلیل نتایج جستوجو و استفاده از هوش مصنوعی میتوانند بخش مهمی از فرایند تولید محتوا باشند. مسئله زمانی آغاز میشود که این ابزارها جایگزین تحلیل مستقل و شناخت نیاز واقعی کاربر شوند.
اگر همه وبسایتها از منابع یکسان استفاده کنند، پرسشهای مشابهی از مدل بپرسند و خروجیها را بدون بررسی تخصصی منتشر کنند، احتمال شباهت محتوایی افزایش پیدا میکند.
این شباهت الزاماً به معنای جریمهشدن سایت یا افت رتبه نیست. گوگل صرفاً به دلیل استفاده از هوش مصنوعی، محتوا را بیارزش تلقی نمیکند. آنچه اهمیت دارد، کیفیت نهایی محتوا، میزان سودمندی آن برای کاربر، اعتبار اطلاعات و رعایت سیاستهای مربوط به محتوای تولیدشده با هدف دستکاری نتایج جستوجو است.
بااینحال، انتشار انبوه صفحات کمارزش میتواند منابع تیم محتوا را هدر دهد، تمایز سایت را کاهش دهد و بهجای تقویت اعتبار موضوعی، مجموعهای از صفحات تکراری و کماثر ایجاد کند.
برای مثال، اگر یک سایت دندانپزشکی ده مقاله درباره انواع ایمپلنت منتشر کند، اما همه آنها توضیحات مشابهی داشته باشند و هیچکدام به نیاز مشخصی از کاربران پاسخ ندهند، افزایش تعداد مقالات لزوماً به بهبود عملکرد ارگانیک منجر نخواهد شد.
در مقابل، یک مقاله دقیق که بر اساس تقاضای واقعی جستوجو، تحلیل رقبا، منابع معتبر و اطلاعات اختصاصی تهیه شده باشد، میتواند ارزش بیشتری برای کاربر و کسبوکار ایجاد کند.
سایت شما در گوگل دیده میشود یا فقط محتوای بیشتری دارد؟
سئو سایت پزشکی در لارن مارکتینگ بر پایه تحلیل تقاضای واقعی جستوجو، رقبا و نیاز بیماران انجام میشود؛ نه تولید انبوه صفحات تکراری.
چگونه از هوش مصنوعی استفاده کنیم، بدون اینکه در چرخه تکرار گرفتار شویم؟
راهکار، کنار گذاشتن هوش مصنوعی نیست. هدف این است که از آن بهعنوان ابزار تحلیل و تسریع فرایند استفاده کنیم، نه منبعی که بدون بررسی، تمام تصمیمهای محتوایی را به آن بسپاریم.
۱. پیش از تولید محتوا، تقاضای جستوجو را بررسی کنید
هر موضوع جذابی الزاماً فرصت مناسبی برای تولید محتوای سئو نیست.
پیش از تهیه مقاله، کلمات کلیدی، میزان تقاضای جستوجو، هدف کاربر و صفحات موجود در نتایج گوگل را بررسی کنید. ابزارهایی مانند Google Search Console و ابزارهای تحقیق کلمات کلیدی میتوانند در این مرحله کمککننده باشند.
همچنین باید مشخص شود که موضوع موردنظر واقعاً به صفحهای مستقل نیاز دارد یا میتوان آن را در یک صفحه جامعتر پوشش داد.
۲. تحلیل رقبا را با بازنویسی رقبا اشتباه نگیرید
بررسی صفحات برتر گوگل باید به شناسایی نیازهای پاسخدادهنشده کاربران منجر شود، نه صرفاً جمعآوری تیترها و ترکیب پاراگرافهای رقبا.
هنگام تحلیل نتایج، مشخص کنید:
- رقبا به چه پرسشهایی پاسخ دادهاند؟
- چه اطلاعاتی را نادیده گرفتهاند؟
- کدام ادعاها نیازمند بررسی بیشتر هستند؟
- چه نوع اطلاعات دستاولی میتوان به محتوا اضافه کرد؟
از هوش مصنوعی بخواهید شکافهای محتوایی را شناسایی کند؛ اما نتیجه را با بررسی مستقیم صفحات و منابع مستقل ارزیابی کنید. (تجزیه و تحلیل رقبا)
۳. اطلاعات دستاول و تخصص واقعی را وارد محتوا کنید
یکی از بهترین راههای متمایزکردن محتوا، استفاده از اطلاعاتی است که بهسادگی در مقالات دیگر پیدا نمیشوند.
این اطلاعات میتوانند شامل تجربه واقعی متخصص، پاسخ به پرسشهای پرتکرار مشتریان، تصاویر اختصاصی، دادههای یک مطالعه، نتایج یک بررسی یا توضیح دقیق یک فرایند باشند.
برای مثال، در سایت یک دندانپزشک، پاسخ مستند به پرسشی که بیماران در جلسات مشاوره مطرح میکنند، ممکن است بسیار ارزشمندتر از چند پاراگراف عمومی درباره مزایای یک درمان باشد.
البته در موضوعات پزشکی، تجربه شخصی بهتنهایی جایگزین شواهد علمی نمیشود و ادعاهای درمانی باید با منابع معتبر و نظر متخصص بررسی شوند.
محتوایی بسازید که دلیلی برای دیدهشدن دارد
تولید محتوای پزشکی تخصصی با تکیه بر دانش پزشک، پرسشهای واقعی بیماران و منابع معتبر؛ محتوایی که اعتماد میسازد و بیمار جذب میکند.
۴. خروجی هوش مصنوعی را پیش از انتشار اعتبارسنجی کنید
روانی متن، ساختار مناسب و لحن حرفهای تضمین نمیکنند که تمام اطلاعات مقاله صحیح باشند.
پیش از انتشار، آمارها، ادعاهای تخصصی، منابع، تاریخها و توصیههای مطرحشده را بررسی کنید. در حوزه پزشکی و سلامت، این مرحله اهمیت ویژهای دارد؛ زیرا اطلاعات نادرست میتوانند بر تصمیمهای واقعی کاربران اثر بگذارند.
همچنین باید بررسی شود که مدل اطلاعاتی را از خودش ساخته، از منبع نامعتبر گرفته یا صرفاً ادعای رقبا را بدون ارزیابی تکرار کرده است.
۵. کیفیت را با تعداد صفحات نسنجید
تعداد مقالات منتشرشده بهتنهایی معیار مناسبی برای سنجش موفقیت استراتژی محتوا نیست.
عملکرد صفحات را با توجه به هدف جستوجو، کلیک ارگانیک، نمایش، جایگاه، تعامل کاربر و میزان تحقق هدف کسبوکار ارزیابی کنید. سپس بررسی کنید که هر صفحه چه ارزش مشخصی به مجموعه محتوای سایت اضافه کرده است.
گاهی ادغام چند صفحه کمارزش، بهروزرسانی یک مقاله قدیمی یا تقویت یک صفحه جامع، تصمیم مناسبتری از انتشار مقالهای جدید است. البته این تصمیم باید بر اساس دادهها و بررسی وضعیت واقعی صفحات گرفته شود، نه یک قاعده ثابت.
جمعبندی: مسئله هوش مصنوعی نیست؛ شیوه استفاده از آن است
داستان خاندان هابسبورگ یادآوری میکند که تکرار یک الگو در یک چرخه محدود، همیشه به معنای پیشرفت نیست. در دنیای هوش مصنوعی نیز وابستگی بیش از حد به خروجیهای مدلهای قبلی، بدون حفظ تنوع و کیفیت دادهها، میتواند به کاهش کیفیت یادگیری منجر شود.
در دنیای محتوا هم شرایط مشابهی وجود دارد: اگر هر سایت فقط محتوای سایتهای دیگر را بازنویسی کند، اینترنت ممکن است از نظر تعداد صفحات غنیتر شود، بدون اینکه به همان نسبت اطلاعات مفیدتری در اختیار کاربران قرار دهد.
برای تیمهای سئو و بازاریابی محتوا، نتیجه روشن است: هوش مصنوعی باید به ما کمک کند بهتر تحقیق کنیم، دقیقتر تحلیل کنیم و محتوای مفیدتری بسازیم؛ نه اینکه صرفاً سرعت تکثیر اطلاعات موجود را افزایش دهیم.
مزیت رقابتی در تولید محتوای بیشتر نیست؛ در تولید محتوایی است که دلیل مشخصی برای وجود داشتن دارد.
میخواهید سایت مطب شما در گوگل و هوش مصنوعی دیده شود؟
با تیم لارن مارکتینگ مشورت کنید تا استراتژی محتوایی بسازیم که بهجای تکرار رقبا، اعتبار و بیمار واقعی برای شما بیاورد.